
サウジのデータセット、アラビア語方言のAIエラーを削減


リヤド:グローバルなコンピューティングと人工知能のリーダーであるNVIDIAは、サウジアラビアのデータとAI権限がサウジ放送局と協力して立ち上げたアラビア語用のサウジオーディオデータセットを使用して、Nemotron 3.5 ASR多言語自動音声認識モデルをトレーニングしたと発表した。
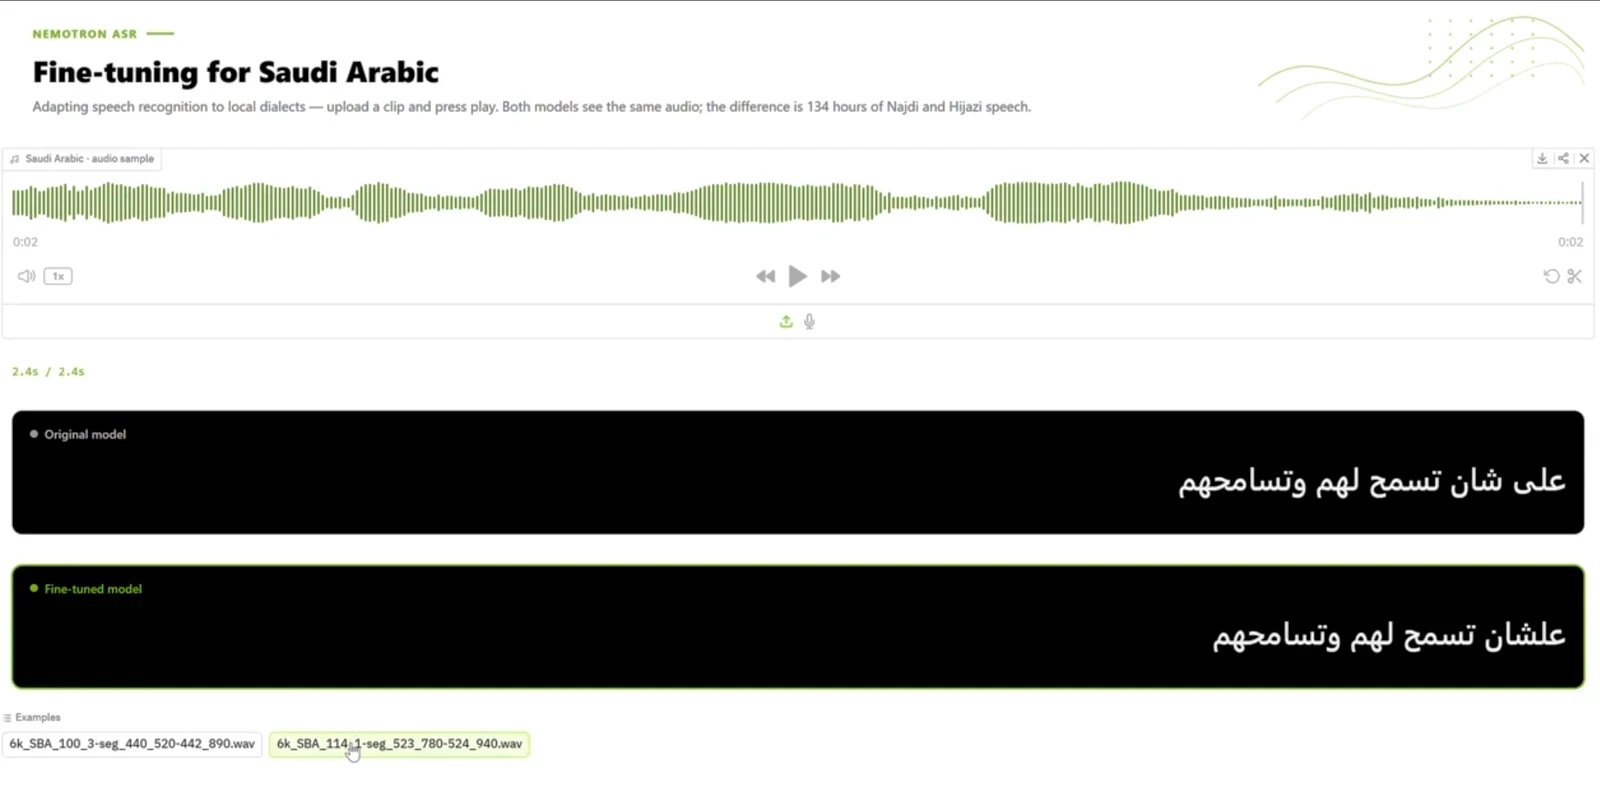
NVIDIAのデベロッパーブログに公開された技術的な研究によれば、このデータセットを統合することでサウジの方言における理解エラーがほぼ半減した。
このモデルはアラビア語を含む約40の言語と方言でリアルタイムの文字起こしをサポートしている。サウジ方言では当初、100単語中約55単語が誤認識されていた。
サウジオーディオデータセットから133.7時間のナジュディとヒジャジの音声で訓練した後、単語誤認率は約30パーセントに低下した。
複数方言の完全なデータセットを通じて、誤認率は58.8パーセントから35.6パーセントに、文字レベルの誤認識も31.6パーセントから12.2パーセントに低下した。現代標準アラビア語や英語でのパフォーマンスも向上した。トレーニングは2つのGPUを使用してわずか4時間半で行われた。
リアルタイムのインタラクティブシステム用に最適化された強化モデルは、遅延が80ミリ秒から始まり、インテリジェント音声アシスタント、会話エージェント、ライブ放送の字幕付け、コールセンター、メディアアーカイブ、会議の文字起こしなどのアプリケーションを可能にする。
NVIDIAは、開発者が世界中でこの手法を他の言語にも適用できるように、必要なワークフローとツールを共有している。
サウジデータとAI権限は、海外の研究者や開発者をサポートするために、Kaggleでアラビア語用サウジオーディオデータセットをリリースした。
このデータセットは、57のテレビ番組とシリーズからサウジ放送局が提供した600時間以上を含む667時間の文字起こしされた音声を含み、10以上のサウジ方言をカバーしている。さらに20時間は検証用に取っておかれている。
このデータセットは、125,000以上のカテゴリー化されたクリップで構成されており、NVIDIAは特定のナジュディとヒジャジの音声データを対象にすることを可能にした。
アラビア語用サウジオーディオデータセットのイニシアチブは、音声認識、音声合成、話者識別、人口統計分類のための高度な音声モデルの開発を支援し、デジタルアラビア語コンテンツにも貢献する。
NVIDIAのデータセットの統合は、高品質な国内データがグローバルなAIシステムが地域の方言をより良く理解し、アラビア語話者向けに特化した技術を改善する役割を果たすことを示している。
SPA